缘起
最近的开源贡献主要集中在 PR-Agent 和 k8sgpt,前面几篇周记也写过一些。之前基本是按 PR 来讲,哪个改了什么、为什么要改。写到后面感觉,里面涉及的一些知识其实可以再展开一点。
比如上下文超限,除了怎么裁剪,还可以看看 Agent 的上下文是怎么组织的;Deployment 的误报,也可以顺着去理解 Kubernetes 的控制器和状态字段。这些东西换个项目也会碰到,只写修复过程的话,好像有点可惜。
所以这篇先介绍两个项目,再挑一些相关的贡献,整理一下它们涉及的通用知识。
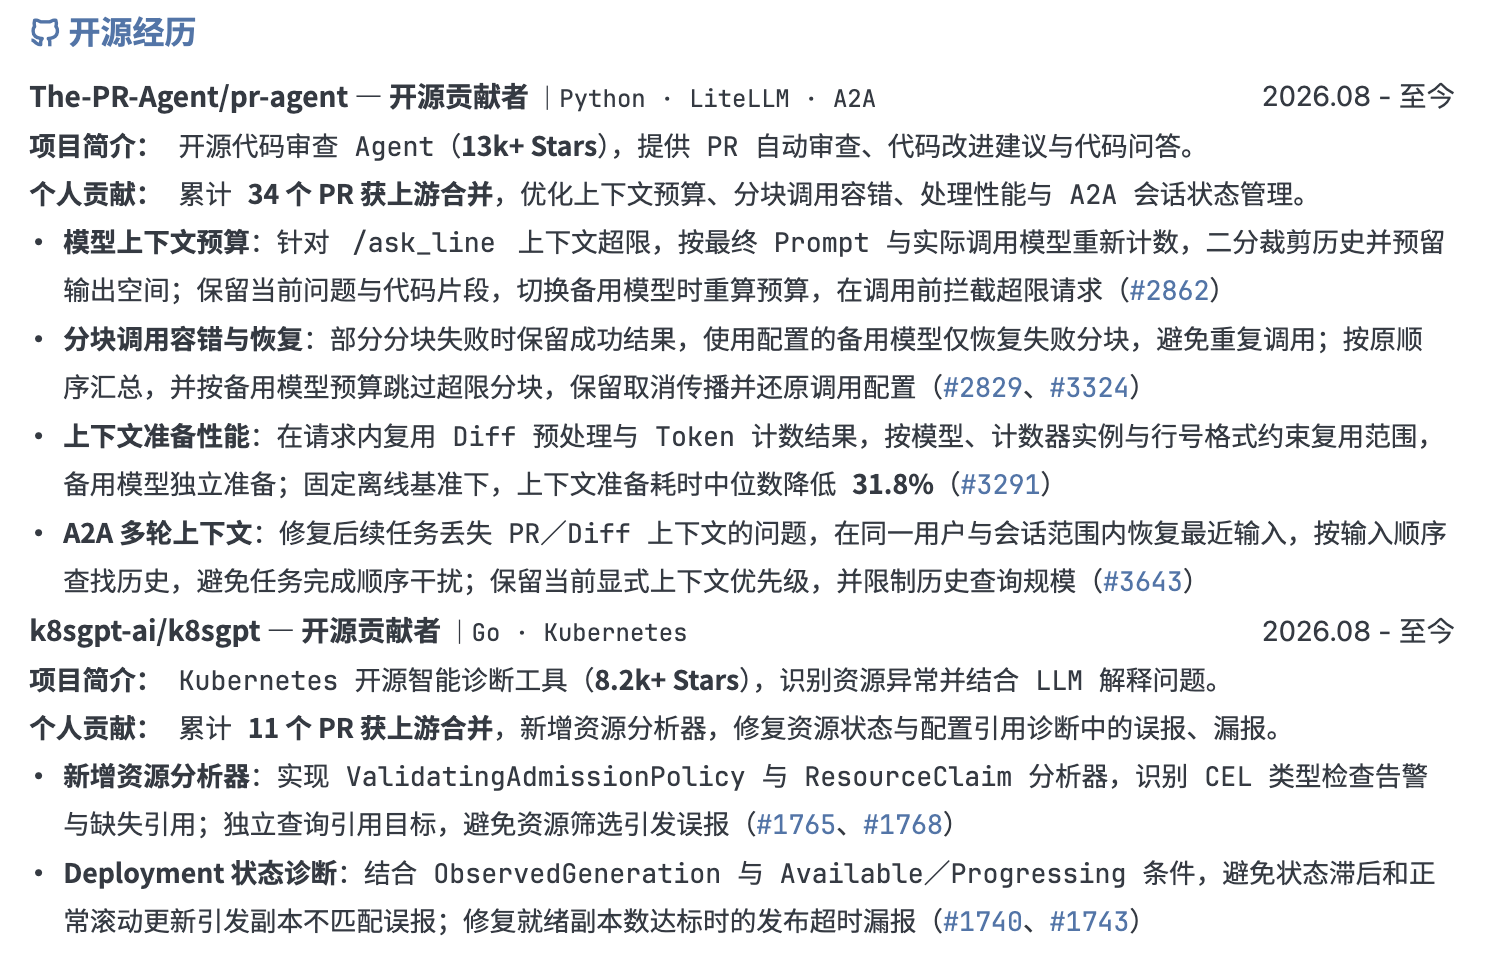
截至 2026 年 10 月 5 日,我在 PR-Agent 有 34 个 PR 被合并,在 k8sgpt 有 11 个。
两个项目
PR-Agent 是一个主要用 Python 编写的 AI 代码审查工具。它接在 PR 工作流里,可以生成变更描述、审查代码、提出修改建议,也可以回答和 PR 有关的问题。常见的命令有 /describe、/review、/improve 和 /ask,支持 GitHub、GitLab 等代码托管平台,有 CLI、GitHub Action 和服务端等运行方式。
举个例子,在 PR 下发一条 /review,它就会读取代码 Diff 和相关信息,准备 Prompt,调用模型,再把结果发布回去。大 Diff 可能要拆成多次调用,模型请求失败时可以尝试备用模型,也可以配置仓库规则和 Skills,让模型参考项目自己的要求。
里面还有一个 MOSAICO 服务入口,通过 A2A(Agent-to-Agent)协议接收请求。请求可以带 PR 地址,也可以直接带 Diff;同一段会话里还可以继续追问。后面讲会话和任务时,会用到这部分。
k8sgpt 是一个用 Go 编写的 Kubernetes 诊断工具。它从集群读取资源,通过不同的 analyzer 检查 Pod、Deployment、Service 等对象。比如 Deployment 发布超时、配置引用缺失,都会有对应的检查逻辑。
执行 k8sgpt analyze 可以得到分析结果,加上 --explain 后,还可以让模型解释原因、给出建议。它支持按资源类型、namespace 等条件筛选,所以既可以看某一类资源,也可以把范围缩小到某个 namespace。
这两个项目里,PR-Agent 的贡献主要涉及上下文、分片调用和任务管理;k8sgpt 这边主要是资源状态和引用关系的误报、漏报修复,还有两个新增 analyzer。
Agent 的上下文管理
做一个围绕代码的问答功能,实际要准备的内容会比问题本身多不少。当前问题、代码片段、仓库规范、之前的讨论,都可能影响回答。换成知识库问答,对应的材料可能就是检索到的文档、来源信息和对话历史。
这些内容最后都要进入模型的上下文。随着对话继续,历史消息和工具返回的内容会越来越多,应用需要决定每一轮具体带上哪些。Anthropic 的上下文工程文章也讨论了这种持续整理输入的过程。
这里可以把历史记录、记忆和当前上下文分开理解。历史记录保存发生过的交互;记忆可以保存从中整理出来、后面仍然需要的信息;当前上下文则是这一轮实际提供给模型的材料。历史保存得很全,也不意味着每轮都应该把它全部发过去。
比如一段很长的讨论里,用户前面确认了“这次只改接口,数据库结构保持原样”,这个约束后面还需要保留。至于已经解决的问题和重复的工具输出,就可以减少。常见做法包括保留最近几轮、对旧历史做摘要,或者把任务目标和已确认的约束单独保存,再按需要取回来。摘要也可能丢信息,所以原始记录和整理后的内容各有用途。
先要处理的还有一个硬限制:上下文窗口。系统提示、当前输入、历史记录、工具结果都会占 Token,通常还需要给模型输出预留空间。不同模型的窗口和计数方式有差异,因此切换模型时,预算也需要跟着重新计算。
PR-Agent 的 /ask_line 就有过这个问题。历史评论是在运行过程中加载的,最开始初始化 TokenHandler 时,还没有这部分内容。PR #2862 把预算检查放到了最终 Prompt 渲染之后,并按当前尝试的模型计数;超限时,优先保留当前问题、代码片段和最近的历史。当前问题与代码本身已经放不下时,就提前报错。
这个例子里采用的是裁剪历史。换成别的任务,可能更适合摘要或者按需检索,取舍要看哪些信息一旦丢掉,就会影响当前任务。比如用户已经确认的限制,未必出现在最近一条消息里,单纯保留最新消息就可能漏掉它。
Skills 也属于上下文的一种来源。PR #2967 给顶层 /ask 接入了部署方配置的 SKILL.md,让问答也能参考安全检查、API 兼容性等指导。这个改动中,Skills 内容经过预算限制后作为文本进入 Prompt,文件路径仍由部署方控制。
准备这些材料时还会遇到缓存问题。一份上下文能否复用,和它来自哪条分支、使用什么配置、为哪个模型准备都有关系。PR #2856 和 #2857 分别补上了仓库指令的分支来源模式和 Skills 的实际配置;#3291 复用准备好的 Diff 时,也限制了模型、TokenHandler 和行号格式。
这和普通缓存的设计是一样的:先确定哪些输入会改变结果,再决定缓存键包含什么。对知识库问答来说,用户权限、文档版本和筛选条件也可能是这些输入的一部分。
会话与任务的状态
用户在同一个窗口里接着提问,通常会觉得前面说过的内容还在。但在实现中,一段会话可以包含很多个任务,每个任务又有自己的输入、执行过程和结果。
A2A 用 contextId 关联一组交互,用 taskId 标识具体任务。协议文档里也有这个区分:一个任务进入完成等终态以后,后续细化要求可以在同一个 context 下启动新任务。比如先做一次 review,再针对结果追问,它们可以属于同一段会话,同时保留各自的任务状态。
应用需要保存它们之间的关系。当前在分析哪个 PR、用户已经确认了什么、上一次产生了哪些结果,这些信息要能被后续请求找到。同一个会话标识可以帮助查询,但真正可用的上下文还要从保存的记录里恢复。
MOSAICO 原来的问题就是,新任务只读取本次消息,后续一句“再看一下安全问题”就找不到之前的 PR。PR #3643 在同一用户和 contextId 范围内,向前找最近带 PR URL 或 Diff 的用户输入;当前消息如果带了新目标,就优先使用当前内容。
这里还有一个时序问题。假设用户先提交 PR A,又提交 PR B,而 A 的任务更慢,最后才完成。如果按完成时间判断“最近的 PR”,就可能重新选回 A。因此这个改动按照输入顺序查找。类似的情况在搜索和异步表单里也会出现:较早发出的请求,可能比较晚才返回。
状态保存在哪里,也会影响后续交互。当前这个实现用的是内存,服务重启或者请求到了另一个副本,就需要重新提供 PR 或 Diff。如果其他系统希望跨重启继续会话,可以考虑外部存储,同时处理用户隔离、过期清理和并发更新。
会话延续和执行恢复还需要分开考虑。保存聊天记录可以让下一轮找到原来的材料;一个做到一半的任务要恢复,则还需要记录已经完成的步骤、结果,以及接下来从哪里继续。对耗时的 Agent 流程来说,这些执行状态也值得单独设计。
重试与部分失败
模型调用、代码平台 API、结果发布,任何一步都可能失败。如果流程拆成多个子任务,还会出现部分成功的情况。
例如 A、C 两个分片已经返回结果,B 请求失败,重新执行整个流程就会再次调用 A、C。多花成本之外,重新生成的内容也未必和第一次一样。所以在设计时,需要先确定结果按什么粒度保存,失败又按什么粒度恢复。
PR #2829 让 /improve 分别收集成功的分片和异常,保留已经成功的结果。PR #3324 又增加了默认关闭的恢复选项,只用剩余配置好的备用模型补跑失败分片,再按原始顺序汇总。
这种处理在批量导入、文档解析等任务里也适用。不过要看子任务是否独立:如果 B 依赖 A 的结果,重试时还要考虑依赖关系和数据版本。PR-Agent 这里的恢复限定在单次调用里,处理抛异常的分片,没有持久化断点续跑。
失败的原因也会影响策略。临时网络错误可以考虑有限重试,上下文已经超限就需要先调整输入;用户主动取消了任务,则需要停止流程。把它们都变成一个“失败,重试”,后续行为就容易出问题。
特别是存在外部操作的时候,请求超时只说明调用方没有按时拿到结果,远端可能已经执行了。例如发布评论时,如果评论已经发出,只是响应丢了,再发一次就可能出现重复内容。这里会涉及幂等性:能否为一次操作保存标识,让重复请求复用已有结果。AWS 关于安全重试的文章讲的就是这类问题。
我做的 PR #3374 利用了 GitHub webhook 的 delivery ID,提供可选的投递去重。同一投递正在执行或者近期已经成功时,重复请求会被抑制;失败或取消后可以重试。这个实现使用进程内状态,各个 worker 和副本之间独立,所以如果要解决多副本的重复执行,还需要另外设计共享状态和协调方式。
执行期间的临时配置也属于需要清理的状态。PR #2929 修的是 fallback 改过 deployment 后没有恢复,影响下一次独立调用的问题。用 finally 恢复进入时的配置,可以覆盖正常返回、异常和取消;并发访问共享配置,则还需要考虑请求之间的隔离。
取消信号也要传到合适的位置。PR #2832 修复了请求入口把 CancelledError 当成普通失败吞掉的问题;#3166 则先建立 A2A 任务的 working 状态,再进入长时间执行的流程,让取消请求有对应的任务可以更新。
Python 的任务取消文档也建议通过 try/finally 做清理,显式捕获取消异常后通常继续传播。对于一个完整流程,还需要处理子任务、临时资源,以及已经发生的外部操作。停止本地等待,也未必能撤销远端已经完成的工作。
Kubernetes 的控制器与状态
k8sgpt 这边的几个问题,需要先从 Kubernetes 的运行方式讲起。
Kubernetes 采用声明式管理。以 Deployment 为例,在 spec 里填写期望的副本数和 Pod 模板,控制器会观察现有资源,再通过创建、更新等操作逐步接近期望状态。这个不断观察和调整的过程,通常叫 reconcile。控制器文档介绍了这种工作方式。
提交一份配置以后,API Server 接受了它,后面还有控制器处理、调度、镜像拉取、容器启动等步骤。这些步骤需要时间,也可能失败。因此在某个时刻看到 spec 和 status 不一致,是有可能的。
spec 描述期望,status 记录观察到的状态。做诊断时,需要看这份观察对应的是哪一代配置,以及控制器目前推进到了哪里。
以 Deployment 为例,metadata.generation 表示期望配置的代数,status.observedGeneration 表示控制器已经观察到的代数。如果后者还小于前者,当前 status 可能没有反映最新修改。此时立刻比较期望副本数和 Ready 副本数,就容易把正常过渡过程报成故障。
PR #1743 就补了这一项判断,还结合 Available=True 和 Progressing=True,避免在相关状态下报告副本数不匹配,同时保留明确的发布超时诊断。
conditions 则把状态拆成不同方面。以 Deployment 为例,Available 反映是否达到最低可用要求,Progressing 反映发布进展。一个 condition 通常包含 type、status、reason 和 message,判断时要按 type 找到对应项,再结合 reason 看具体含义。
比如期望有 3 个副本,目前也有 3 个 Ready Pod,但它们可能都属于旧 ReplicaSet,新版本一直没起来。应用还有可用副本,发布却可能已经超时。PR #1740 因此补查 Progressing=False / ProgressDeadlineExceeded,避免只看数量造成漏报。
还有一个细节,Progressing=True 也会出现在发布完成之后,此时 reason 可以是 NewReplicaSetAvailable。所以它的含义要结合 reason 理解,不能直接读成“正在更新”。Deployment 文档对此有具体说明。
其他资源也有类似的状态组合。Gateway 的 Accepted 和 Programmed 分别描述被接受和完成配置,PR #1737 改成按 type 查找它们。ReplicaSet 已经有部分 Pod,后续创建仍然可能失败,所以 #1750 独立检查 ReplicaFailure=True / FailedCreate。
Job 则需要结合历史和最终结果。失败过几个 Pod,重试之后仍然可能完成;status.failed 会留下失败次数。PR #1725 结合 Complete=True 或 SuccessCriteriaMet=True 判断成功,避免把重试后成功的 Job 报成失败。
其中 SuccessCriteriaMet 表示成功条件已经满足,Complete 则是更后面的终态,二者在 Job 生命周期里还有时间上的区别。这个修复用它们判断是否应跳过失败计数告警,并没有把两个状态合并成同一个概念。
看这些状态时,可以分别确认:当前记录是否对应最新配置、哪些方面已经满足条件、有没有明确的失败原因。这样再去看副本数或失败次数,比较容易理解它们为什么会和直觉不一样。
资源身份、引用与依赖
Kubernetes 的资源查询还需要考虑范围。对于有 namespace 的资源,同名对象可以分别存在于不同 namespace;不同资源类型也可能使用同一个名字。查询一个引用时,要知道目标是什么类型、在哪个范围内,单凭名字还不够。
对象还有 UID。同名资源删除后重新创建,名字可以一样,UID 会变化。如果需要关联某个具体对象的事件或历史,UID 就可以帮助区分这两次创建。对象名称与 ID 文档介绍了这些标识。
Label 和 selector 则用于选出一组对象。它们适合表达“哪些 Pod 属于这个应用”,但相同 label 可以出现在不同 namespace,也不能代替对象身份。
PR #1747 修的 NetworkPolicy 问题就和这个有关。policy 位于 team-a,team-a 没有符合 app=api 的 Pod,team-b 才有;原来全局分析时可能拿 team-b 的 Pod 满足选择条件。这次把查询范围改成 policy 自己的 namespace。
这里对应的是 policy 的 spec.podSelector,它选择当前 namespace 中要被策略作用的 Pod。至于允许哪些来源或目的地,ingress、egress 规则还可以通过 namespaceSelector 等条件涉及其他 namespace。这两层在 NetworkPolicy 的定义里是分开的。
RBAC 里也要分清引用对象和授权范围。Role 属于 namespace,ClusterRole 是集群级对象;RoleBinding 可以引用同 namespace 的 Role,也可以引用 ClusterRole。
PR #1755 让 analyzer 按 roleRef.kind 查询 Role 或 ClusterRole。引用 ClusterRole 时,RoleBinding 仍在自己的 namespace 范围内授予权限;要在集群范围授予 ClusterRole 的权限,使用的是 ClusterRoleBinding。RBAC 文档有相应例子。
除了查对对象,还要查全引用入口。ConfigMap 可以从普通容器的环境变量被使用,也可以通过 init container、直接 volume 或 projected volume 进入 Pod。PR #1722 和 #1741 分别补查了 init container 和 projected volume,避免把这些 ConfigMap 报成未使用。
资源之间存在依赖时,筛选当前分析对象和查询它的依赖,也需要分别处理。比如只分析带 app=demo 标签的 ResourceClaim,它引用的 DeviceClass 可能由平台统一管理,根本没有这个标签。如果把同一个筛选条件套到 DeviceClass 上,就会把存在的依赖过滤掉。
新增的 ResourceClaim analyzer,PR #1768 就把这两种查询分开了。它涉及 Kubernetes 的动态资源分配(DRA),检查 claim 引用的 DeviceClass 是否存在;相同 claim 中重复的缺失引用只报告一次。这项检查关注类别引用,进一步的设备分配状态需要另外分析。
另一个新增的 ValidatingAdmissionPolicy analyzer,PR #1765 也有同样的处理。ValidatingAdmissionPolicy 使用 CEL 表达式声明准入校验规则,Binding 关联策略和适用范围。这个 analyzer 提取已有的 CEL 类型检查告警,并检查 Binding 引用的 policy 是否缺失;被引用的 policy 即使不符合当前分析的标签条件,也会独立解析。
这类“主对象和依赖使用不同查询范围”的情况,在普通业务里也会遇到。比如筛选某一批订单以后,查订单关联的用户,往往就需要按引用的用户 ID 查询,而不能继续套用订单的筛选条件。
诊断结果的依据与范围
最后还有一组问题,两个项目都会碰到:输入不完整时,结果应该怎么表达。
代码审查受 Token 和调用次数限制,可能只有部分文件进入模型。此时返回“没有建议”,读者很容易理解成整个 PR 都检查过了。但实际只检查了其中一部分,剩余文件的情况还不知道。
PR #3645 让 /improve 保留预算遗漏的文件,并纳入已有的覆盖范围提示。它没有增加调用次数,补的是结果对应的分析范围。这次仍不包括单个文件内部被 clip 截掉的内容。
查询资源时也一样。文件返回 404,可以按不存在处理;远端返回 500,则只能知道本次读取失败。PR #2793 保留了这两种情况的区别,让非 404 的读取错误向上传播,避免把失败缓存成空上下文。
所以一份诊断里,最好能同时知道发现了什么、检查了哪些材料,以及哪些地方没能检查。对于日志分析、知识库问答、批量扫描,这些信息都会影响读者怎样理解结果。
k8sgpt 的规则分析和模型解释也可以按这个顺序理解:先拿到资源状态、引用关系等依据,再根据依据解释原因。如果来源查询失败,或者判断条件本身漏掉了一种状态,后续还需要补充检查。
做类似的诊断系统时,可以把来源对象、判断字段、分析范围和解释结果关联保存。这样回头查一个结论,就能找到它依据哪份记录、哪项条件;材料不全的地方,也可以继续查询。模型给出的推测,则可以保留为待验证的原因或建议。
拾得
这次复盘主要还是想把相关的基础知识理清楚。上下文怎么组织、任务失败以后怎么处理,还有 Kubernetes 的状态和资源引用,这些内容之前分散在不同的 PR 里,这篇就把它们放在一起整理了一遍。