最近我给个人项目 映知 VidLens 做了一轮比较集中的完善,最新版本已经部署到线上。这次既修了一些会影响使用体验的问题,也补上了从视频处理、问答到学习笔记的一些功能。
先说一下线上体验的限制,再整理这轮的主要改动。
线上体验说明
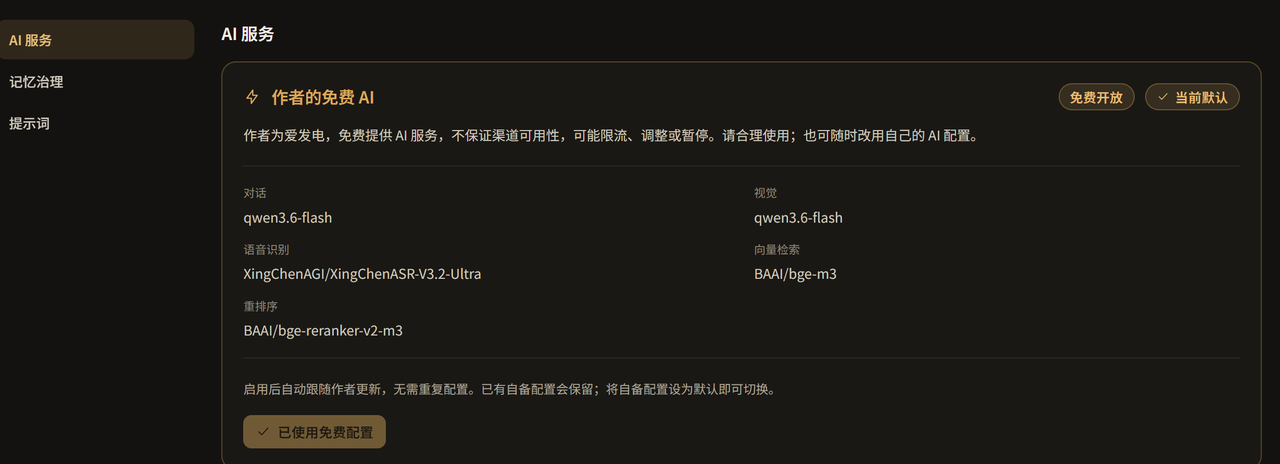
网站提供了我的免费 AI 配置。当前对话和视觉能力使用的都是 qwen3.6-flash;语音识别、向量检索和重排序分别使用硅基流动的免费模型:XingChenAGI/XingChenASR-V3.2-Ultra、BAAI/bge-m3 和 BAAI/bge-reranker-v2-m3。
免费配置可能限流、调整或暂停,不保证一直可用。启用后可以跟随作者更新;已有的自备配置会保留,也可以切换回去。
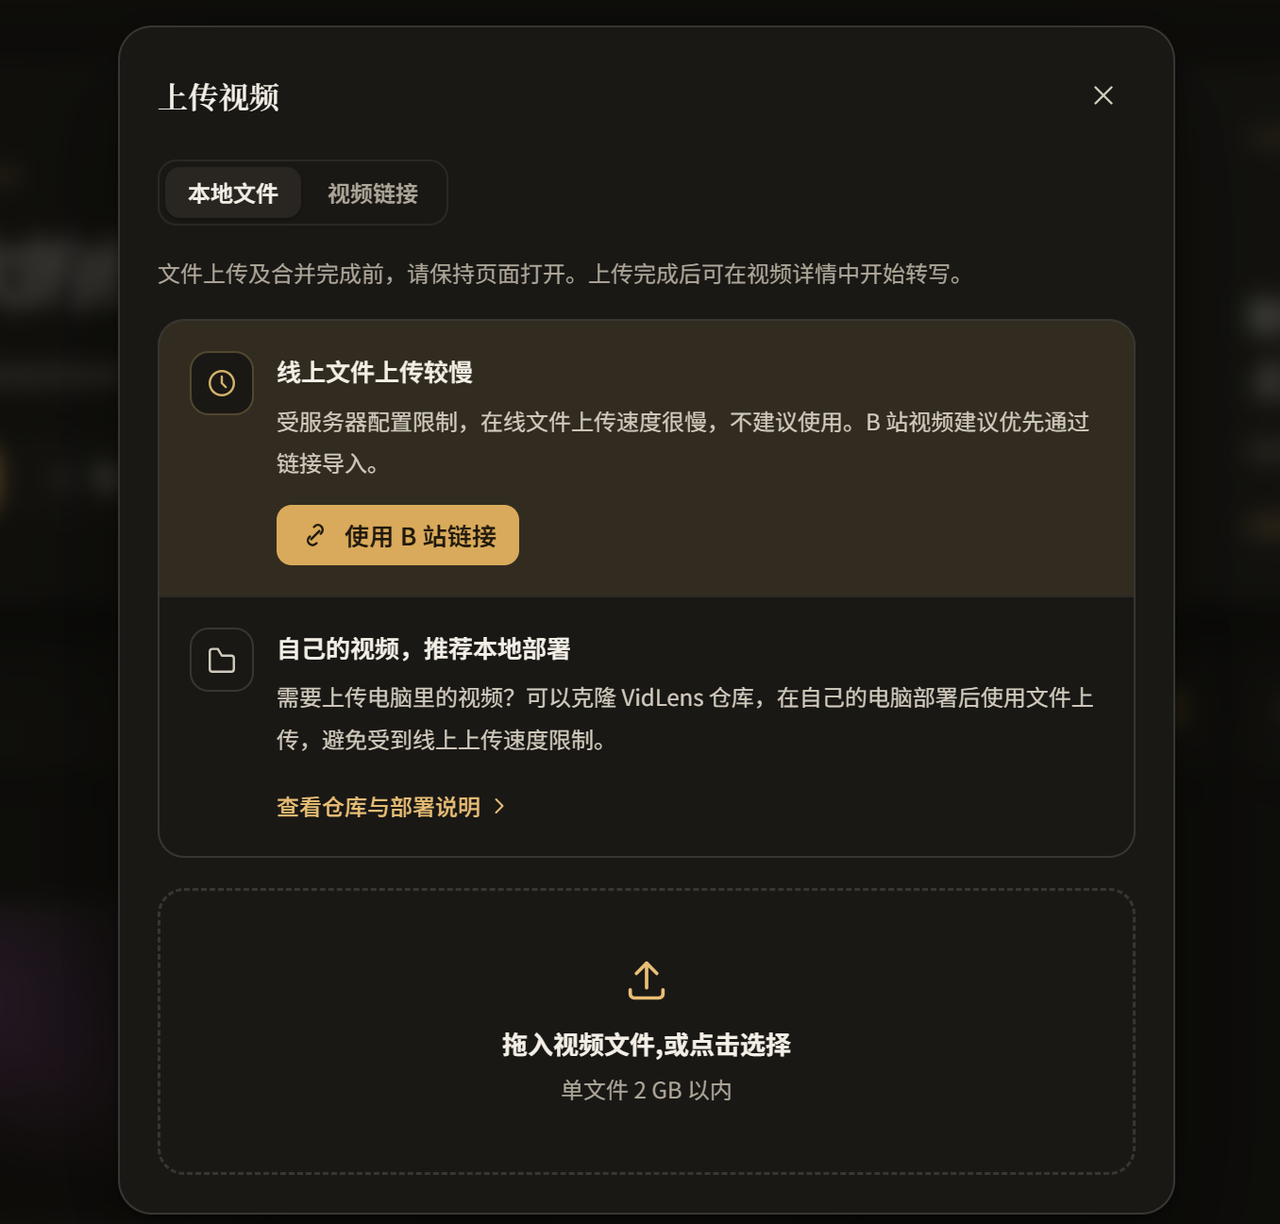
线上文件上传速度比较慢,大文件还会受到服务器性能和剩余磁盘空间的限制。上传窗口虽然显示单文件可在 2 GB 以内,但这不代表线上实例能稳定承载这么大的文件;百兆级以上的视频尤其不建议直接上传。想处理自己的视频,克隆项目仓库并在本机部署会更合适。
网站也提供视频链接导入,当前页面优先引导使用 B 站链接。我在这套部署上验证过 B 站视频;下载由 yt-dlp 执行,B 站请求会使用服务器配置的 cookies。其他来源是否可用取决于服务器配置和网络环境,我目前不做保证。
这仍然是一个主要借助 AI 完成代码开发的个人学习项目,目前偏实验性质。Agent 的回答质量、执行过程和整体体验还在持续完善,生成内容也需要自行核对。欢迎体验后反馈具体问题和建议,友好交流,非常感谢 🙏
这轮比较重要的修复
Agent 问答之前有时会遇到两种情况:复杂任务因为执行预算不足而过早结束;另一些问题则会反复检索相同的视频内容,耗费很长时间。这次我扩大了多步任务的默认预算,并增加了重复检索和连续缺少新证据时的收束处理。Agent 会基于已有证据组织回答,并说明哪些部分还没有确认。
页面状态也补了一轮恢复处理。切换聊天时回答偶尔会串到别的会话,首次提问有时会重复提交,历史读取失败也可能看起来像记录消失。现在会更谨慎地处理旧请求,避免它覆盖当前状态;封面、播放源、学习位置和任务状态读取失败后,也能重新读取或重试。
视频重新处理时,任务状态和内容曾经可能不同步,例如转写完成了,页面仍显示“转写中”;摘要也可能被画面分析或索引任务拖住。这次拆出了独立的摘要任务,并修正了阶段状态、强制重生成的保存,以及重新转写后的索引失效和重建流程。
视频处理、问答与学习笔记
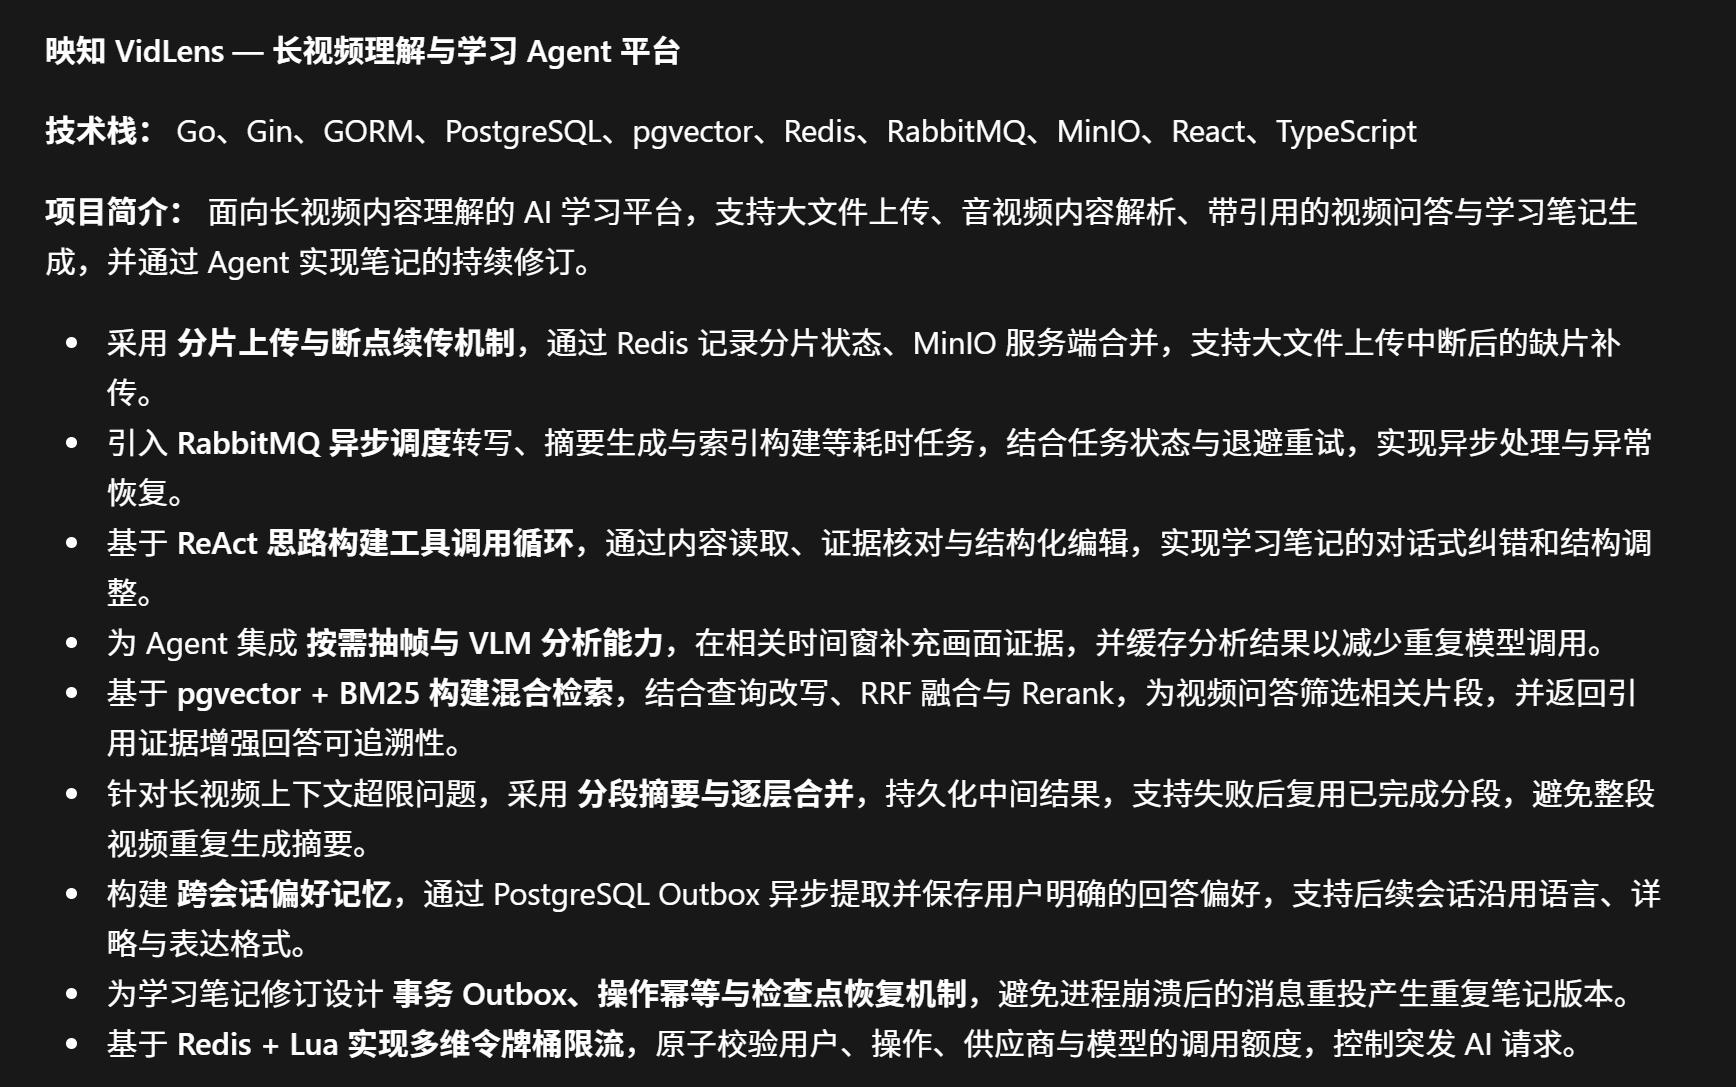
视频处理页面现在能查看转写分片、画面分析和后续处理阶段的进度,并区分排队、执行和重试状态。长视频摘要采用分段生成、逐层合并的方式;重试时也可以复用已经完成的摘要片段。
问答入口增加了“问整个视频库”,可以在已索引的视频中查找相关内容。我也完善了推荐问题、回答后的追问建议,以及历史会话里的执行过程和当轮配置展示。
画面分析可以按需关闭,或选择只识别画面文字、只生成视觉描述,或同时开启两者。已经完成转写的视频也可以单独生成或重建画面证据,不必重新转写。
学习笔记、思维导图和可编辑知识画布也补齐了一些工作流。整理出的章节、概念和例子可以引用回对应视频片段;节点和关系可以手动调整,笔记还能导出为 Markdown。
AI 修订支持用自然语言修改摘要、整篇笔记或指定段落,并查看修改差异、撤销相关修改。摘要可以保存当前视频的术语规则,笔记则保留历史版本。
视频、笔记和问答之间也连得更紧了:阅读笔记时可以针对某个段落提问,把有用的回答收进笔记,并保存上次的学习位置,方便之后接着看。
AI 配置现在支持导入导出、各项模型能力的实际调用检查和 Embedding 维度探测;也可以按用途设置提示词偏好,调整回答和内容整理的风格。
前端迁移到了 Vite + React,并重新整理了主要页面布局、移动端适配、加载状态和交互反馈,也补充了项目介绍页和使用文档。
这一轮主要是在把视频处理、问答和学习记录串成更完整的流程。项目还会继续迭代,欢迎体验后告诉我哪些地方不顺手。